n8n: как собрать ИИ-агентов с памятью, согласованием и мониторингом. Пошагово
Содержание
- Что понадобится
- Если вы работаете из России
- Риски перед стартом
- Шаг 1. Холст и триггеры
- Шаг 2. Первый поток: форма, очистка, условие, письмо
- Шаг 3. Агент, который ищет в таблицах
- Шаг 4. Данные из внешнего API
- Шаг 5. ИИ принимает решение
- Шаг 6. Агент и модель
- Шаг 7. База знаний и долгая память
- Шаг 8. Несколько агентов вместо одного
- Шаг 9. Реакция на события
- Шаг 10. Человек в цикле
- Шаг 11. Ошибки и мониторинг
- Что дальше
Обычная автоматизация гоняет данные из одного сервиса в другой по расписанию или по кнопке. Как только нужно что-то понять, написать или выбрать, приходится звать человека. ИИ-агент закрывает эту дыру: читает запрос, сам решает, какой инструмент взять, и возвращает результат.
n8n это визуальный конструктор, где такие процессы собирают из блоков на холсте. Это не просто соединитель сервисов, а основа для целых систем: от разбора заявок до чат-бота с памятью. Код открыт, n8n можно скачать с GitHub и запустить у себя. О нём сейчас много говорят из-за связки с ИИ: агентов, памяти, согласования человеком и контроля ошибок можно собрать без программирования.
Разбираем по шагам путь от первого потока до системы из нескольких агентов.
Что понадобится
- n8n. Для пробы хватит запуска на своём компьютере, для постоянной работы нужен свой сервер. Есть и платный облачный тариф.
- Языковая модель. В примерах это GPT-4o mini через OpenAI.
- Сервисы под задачу. В примерах Google Sheets, Telegram, Gmail и Slack.
- Учётные данные. Ключи хранятся в учётных данных n8n, а не прямо в блоках на холсте.
Если вы работаете из России
Сам n8n открытый и ставится на ваш сервер, зависеть тут не от чего. Вопрос в сервисах вокруг него.
- Модель. OpenAI из России напрямую недоступен. По документации, n8n умеет работать с локальными моделями через Ollama: открытая модель на своём сервере, данные никуда не уходят.
- Российские модели. Блок HTTP-запроса говорит с любым API. Если у российской модели есть открытое API, её можно подключить так. Условия конкретного сервиса проверьте сами.
- Согласование. Telegram в примерах уже есть, и его можно взять вместо Slack. Проверьте в документации, есть ли у нужного блока режим «отправить и ждать ответа».
- Поиск. В примере его делает SerpAPI, внешний сервис. Заменяется любым поиском с API.
Риски перед стартом
- ИИ ошибается. Письмо может выйти не в тоне или просто странным. Всё, что уходит клиенту, пускайте через согласование.
- Тихие сбои. Если таблица недоступна или агент не ответил, поток может молча упасть. Лечится шагом 11.
- Данные. Всё, что вы отправляете в облачную модель, уходит за пределы компании. Персональные данные и коммерческие секреты туда не отправляйте.
- Расходы. Каждый вызов ИИ тратит токены, считайте их с первого дня.
- Пробные данные. В примерах на вебхук закреплены тестовые данные, чтобы запускать поток без реальных обращений. Перед боевым запуском их открепляют.
Шаг 1. Холст и триггеры
В рабочем пространстве есть личный раздел и общий для команды. Процессы собирают на холсте, а на вкладке запусков видно, какие потоки прошли и какие упали.
Любой поток начинается с триггера: вручную, по событию в приложении, по расписанию, через вебхук или сообщением в чате. К нему подключают блоки: запросы к API, преобразование данных, циклы, параллельные ветки, согласования.
Шаг 2. Первый поток: форма, очистка, условие, письмо
Для примера возьмём цепочку из пяти блоков: вебхук, очистка полей, условие, ИИ, письмо.
Вебхук принимает POST-запрос по заданному пути, в примере это architecture-demo. Как только форма или любой сервис отправит данные на этот адрес, поток стартует. Для проверки закреплён пробный JSON с тремя полями: имя, почта, компания.
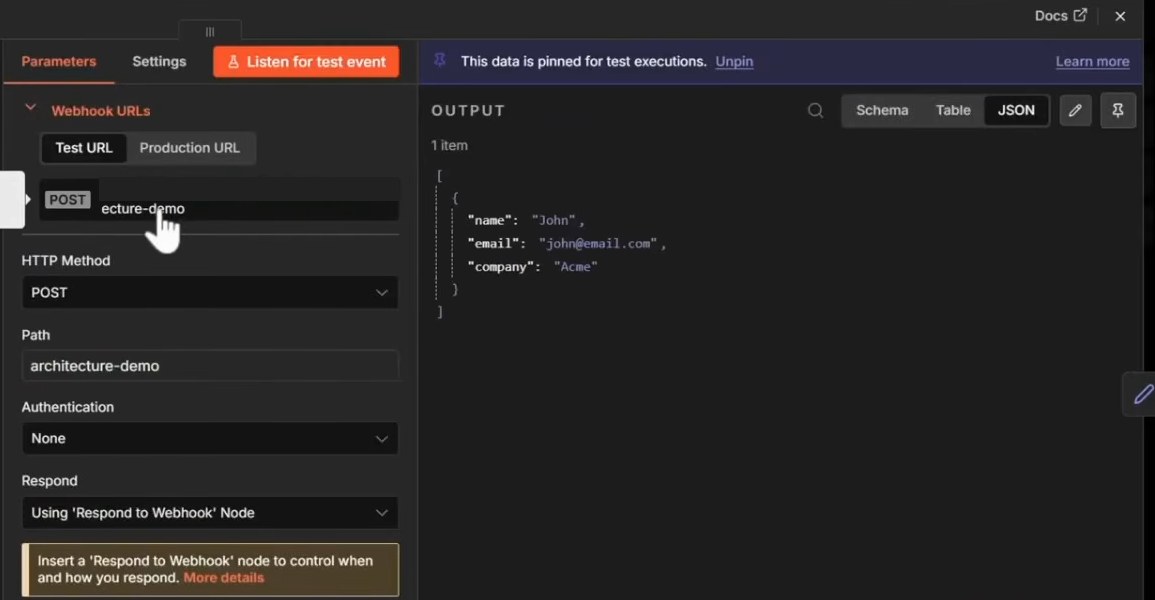
Блок Set достаёт из запроса чистые поля и может добавить своё, которого в запросе не было. Блок условия проверяет, что компания не пустая. Если пустая, эту ветку можно отправить на другой шаблон письма или в оповещение.
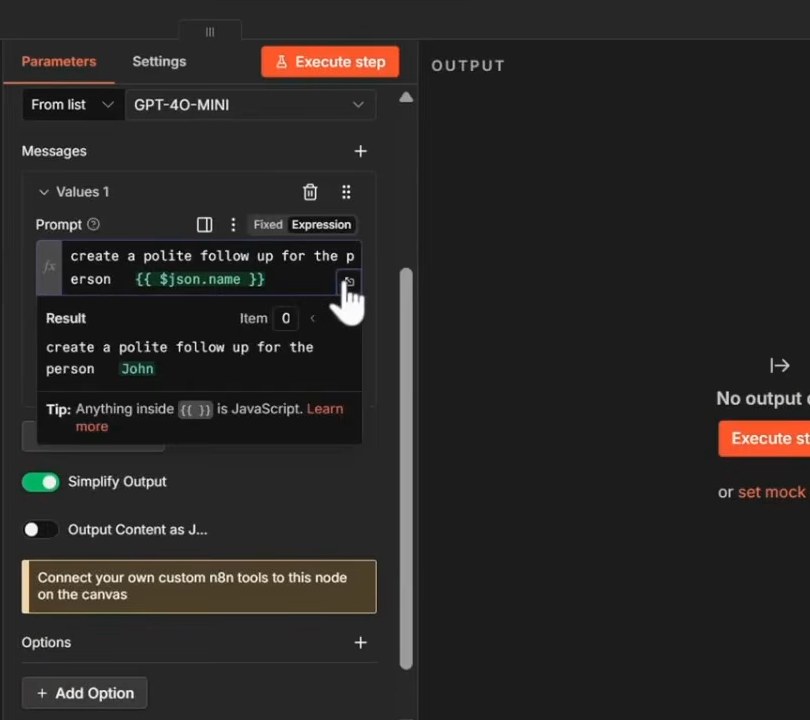
Затем блок OpenAI с моделью GPT-4o mini. В запрос подставляется имя из предыдущего блока, поэтому каждый запуск получает свой текст.
Составь вежливое письмо-напоминание для человека {{ $json.name }}.
Ответ приходит в поле message.content, и Gmail отправляет его. В журнале запуска виден весь путь данных от вебхука до письма.
Шаг 3. Агент, который ищет в таблицах
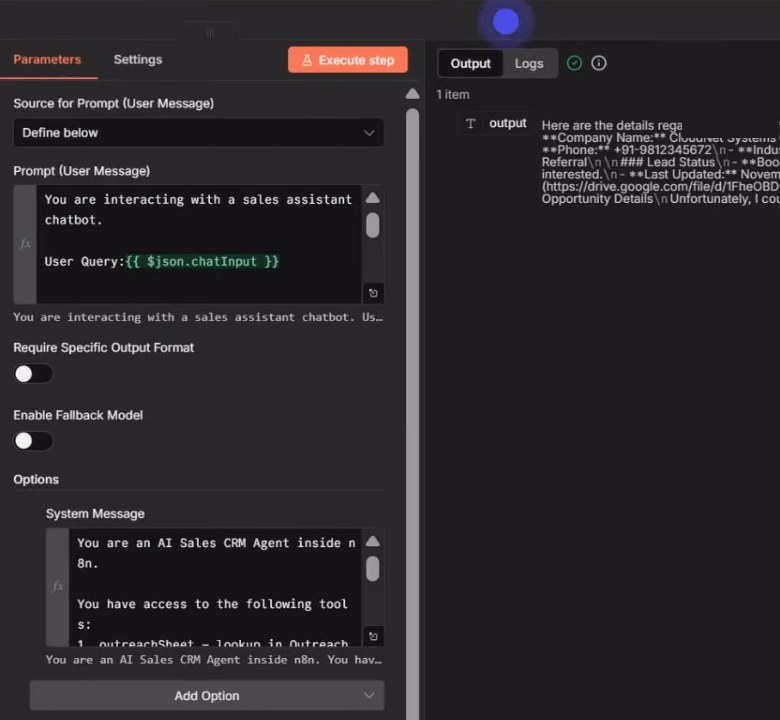
Теперь первый агент: чат-бот для продаж. Он отвечает на вопросы по лидам и сделкам и не выдумывает, а сначала ищет в таблице.
- Триггер чата. Запускает поток, когда пользователь пишет в чат n8n.
- Модель и агент. Агент решает, в какую таблицу идти: по лидам или по сделкам.
- Два инструмента. Две таблицы Google Sheets: статус лидов со ссылками на предложения и сделки с воронкой.
- Память. Хранит несколько последних реплик, чтобы бот понимал контекст сессии.
- Проверка ответа. Если ответ пустой, обращение пишется в таблицу ошибок, а поток не ломается.
- Журнал. Каждая реплика сохраняется в таблицу со временем, сессией, вопросом и ответом.
В системном сообщении агента перечислены его инструменты и сказано, что сначала нужно смотреть данные.
Шаг 4. Данные из внешнего API
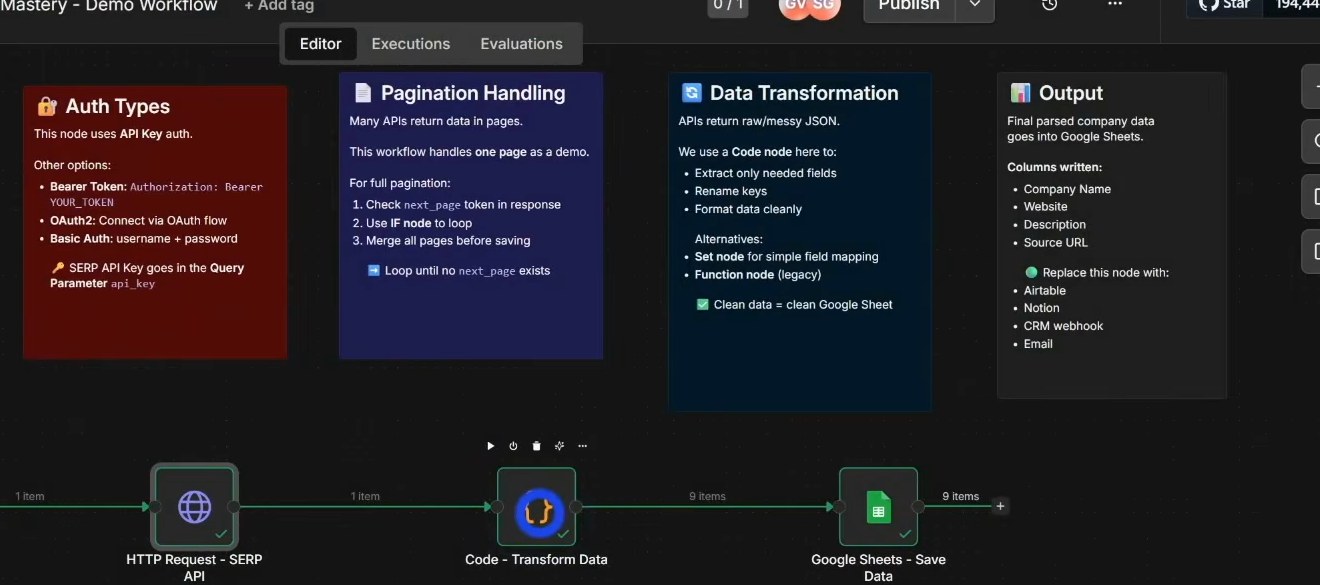
Блок HTTP-запроса подключает n8n к любому сервису с API. GET забирает данные, POST отправляет, PUT обновляет, DELETE удаляет. Вход бывает по ключу, токену, OAuth2 или логину с паролем.
В примере это поиск через SerpAPI: движок Google, запрос и десять результатов. Ключ берётся из сохранённых учётных данных. Если ответ разбит на страницы, проверяют токен следующей страницы и повторяют запрос, пока он есть.
Ответ приходит громоздким, поэтому блок Code оставляет только нужное: название компании, сайт, описание, ссылку и отметку времени. Блок Google Sheets в режиме добавления дописывает строки и ничего не стирает. Его легко заменить на Airtable, Notion, CRM или письмо.
Шаг 5. ИИ принимает решение
Любая ИИ-автоматизация это четыре шага: вход, анализ, решение, действие.
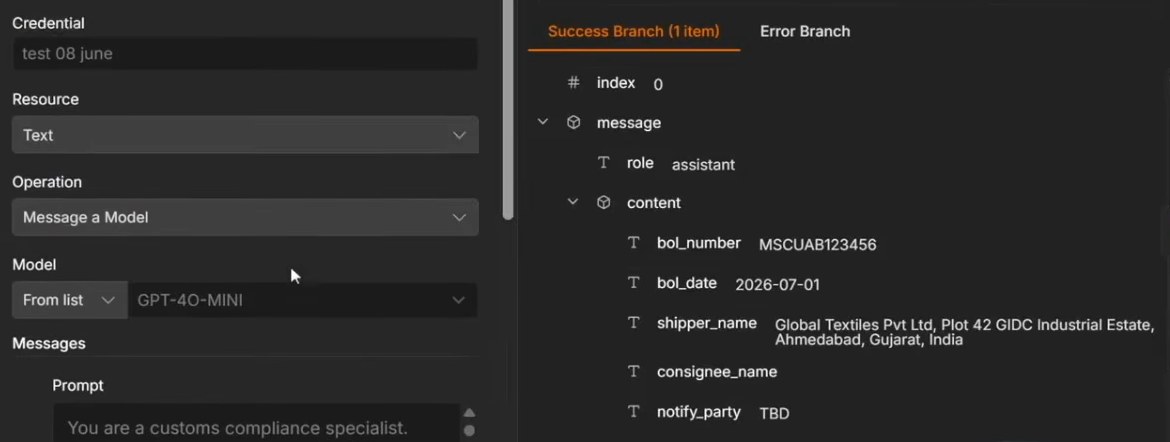
В примере на вход приходит текст коносамента, документа на перевозку груза. Главное здесь запрос. Если написать «прочитай документ», в ответ придёт абзац, а абзац не автоматизируешь. Поэтому модели прямо называют поля: номер, отправитель, получатель, судно, порты, и требуют ответ в JSON.
Блок Code превращает ответ в предсказуемые поля. Блок условия проверяет, заполнены ли номер, отправитель и получатель. Если чего-то нет, поток сразу отправляет письмо: какой документ и какое поле требуют внимания. Тот же приём подходит для счетов, обращений в поддержку и договоров.
Шаг 6. Агент и модель
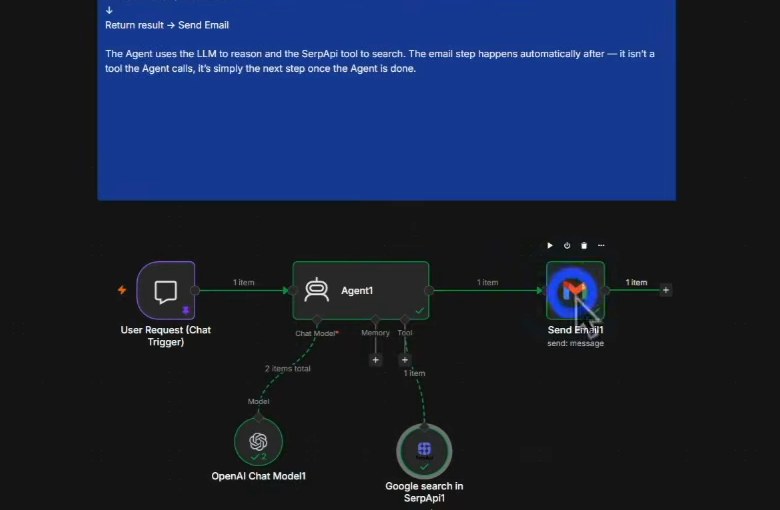
Модель это генератор текста: слова на входе, слова на выходе. Агент выбирает инструмент и достаёт настоящие данные. В n8n агент это отдельный блок, а модель подключается к нему снизу.
Простой пример: агент ищет в сети и присылает итог на почту. Триггер чата с готовым запросом, агент с моделью OpenAI, один инструмент поиска Google и блок письма.
Найди крупные сделки, закрытые в этом квартале, с суммой больше 50 000 долларов.
В системном сообщении агенту поручено искать информацию и ясно её подытожить, потому что итог сразу уйдёт по почте. Письмо это не инструмент агента, а обычный следующий блок. Один инструмент с одной задачей часто лучше пяти, которыми агент почти не пользуется.
Шаг 7. База знаний и долгая память
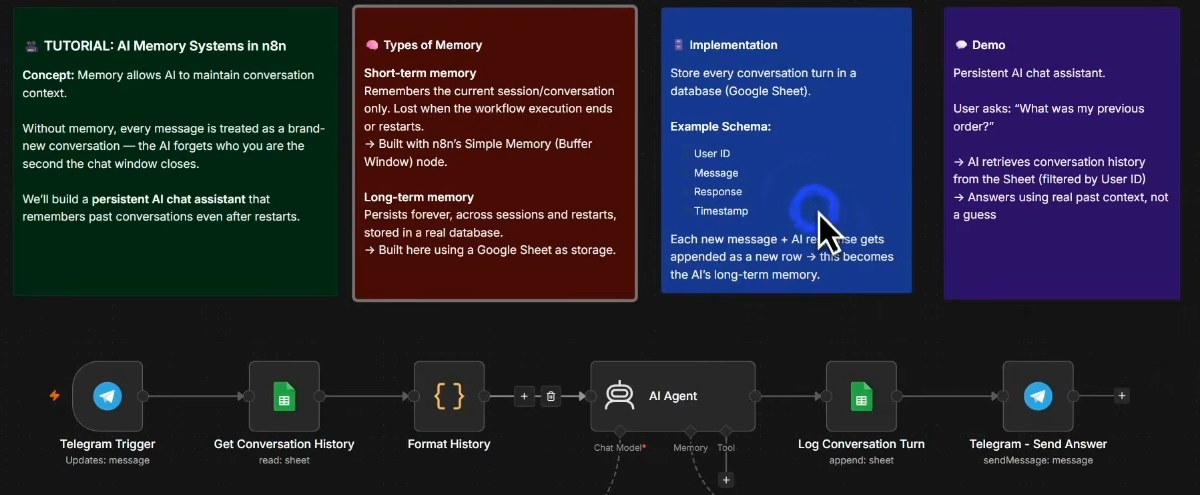
Для небольшой базы знаний векторная база не нужна. Чат-бот в Telegram получает вопрос о возврате или доставке, агент идёт в таблицу как в инструмент и находит строку с колонками вопрос, ответ и категория. Модель лишь формулирует ответ.
Память бывает двух видов. Краткая живёт в рамках сессии: блок Simple Memory хранит последние реплики. Долгая лежит в таблице из четырёх колонок: ID пользователя, сообщение, ответ и время.
Поток такой: Telegram принимает сообщение, блок читает историю этого пользователя, код собирает её в текст для системного сообщения агента. Агент отвечает, реплика записывается в таблицу, ответ уходит в Telegram. Проверка: в новой сессии бот вспоминает заказ красной футболки размера M. Таблицу можно открыть и поправить память вручную.
Шаг 8. Несколько агентов вместо одного
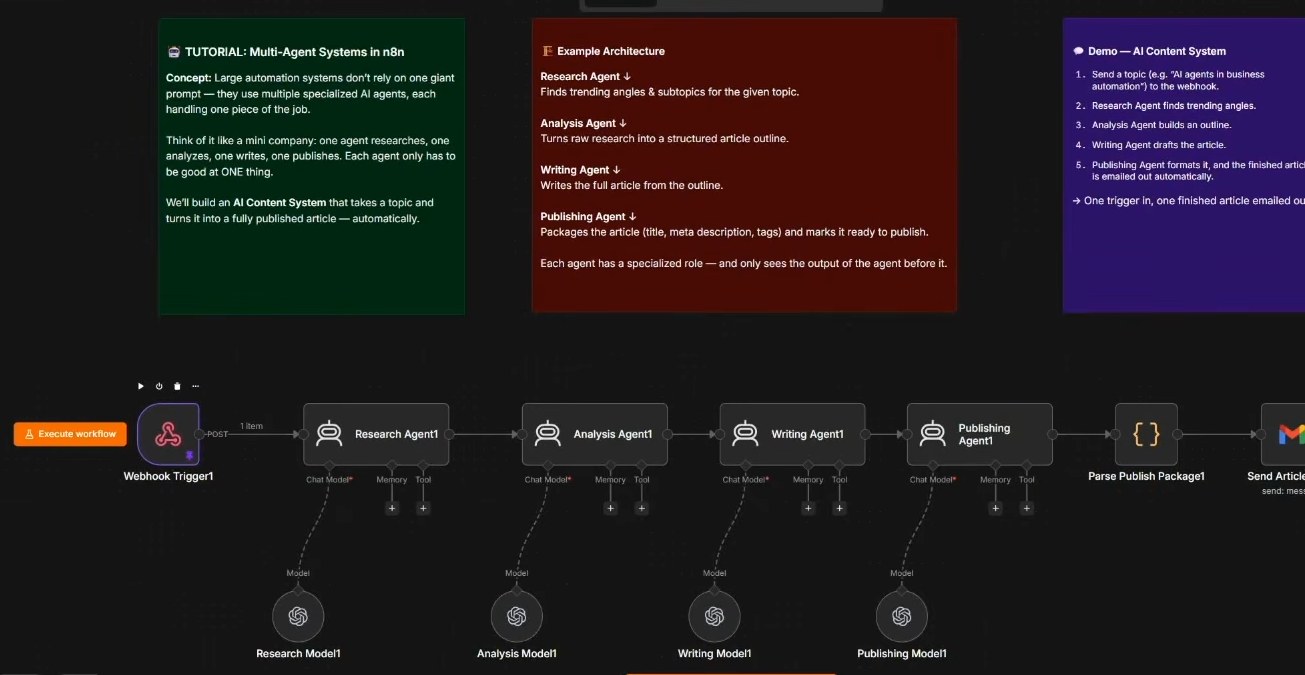
Когда один агент делает всё, запрос разбухает, модель путается, качество падает. Решение то же, что в команде: каждому одна роль. Выход одного агента становится входом следующего.
- Исследователь. Только собирает материал. В запросе сказано: твоя единственная задача исследование, статью не пиши.
- Аналитик. Превращает заметки в план в JSON: заголовок, зачин, разделы.
- Писатель. Пишет статью по плану в markdown.
- Публикатор. Готовит заголовок для поиска, описание, теги и ставит статус «опубликовано».
Старт даёт вебхук с темой. После публикатора стоит блок Code на случай, если модель обернула JSON в разметку. Готовая статья уходит письмом. Одна тема на входе, один материал на выходе, без участия человека.
Шаг 9. Реакция на события
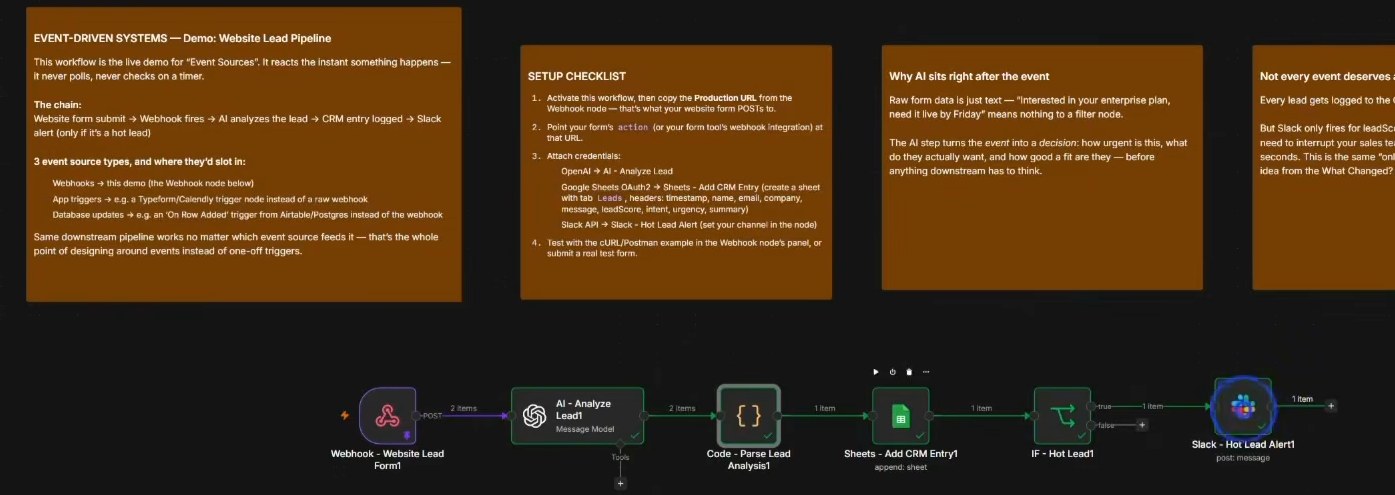
Опрашивать сервис каждые 15 минут значит делать 96 запусков в день ради одного события. Рабочие системы реагируют сразу. Источников три: вебхук, триггеры конкретных приложений и изменения в базе, например новая строка в Airtable, Postgres или Google Sheets. Любой можно поставить в начало, остальной поток не меняется.
Пример: форма на сайте, вебхук, ИИ-анализ, запись в CRM, оповещение в Slack.
- ИИ-анализ. Возвращает оценку заявки из 10, намерение, срочность и сводку в одну строку.
- Таблица. Записывается каждая заявка, горячая и холодная.
- Фильтр. Если оценка 7 или выше, уходит оповещение в Slack. Остальные никого не отвлекают.
Полезный приём: поле, которого нет в выходе предыдущего блока, можно взять из более раннего по имени.
Шаг 10. Человек в цикле
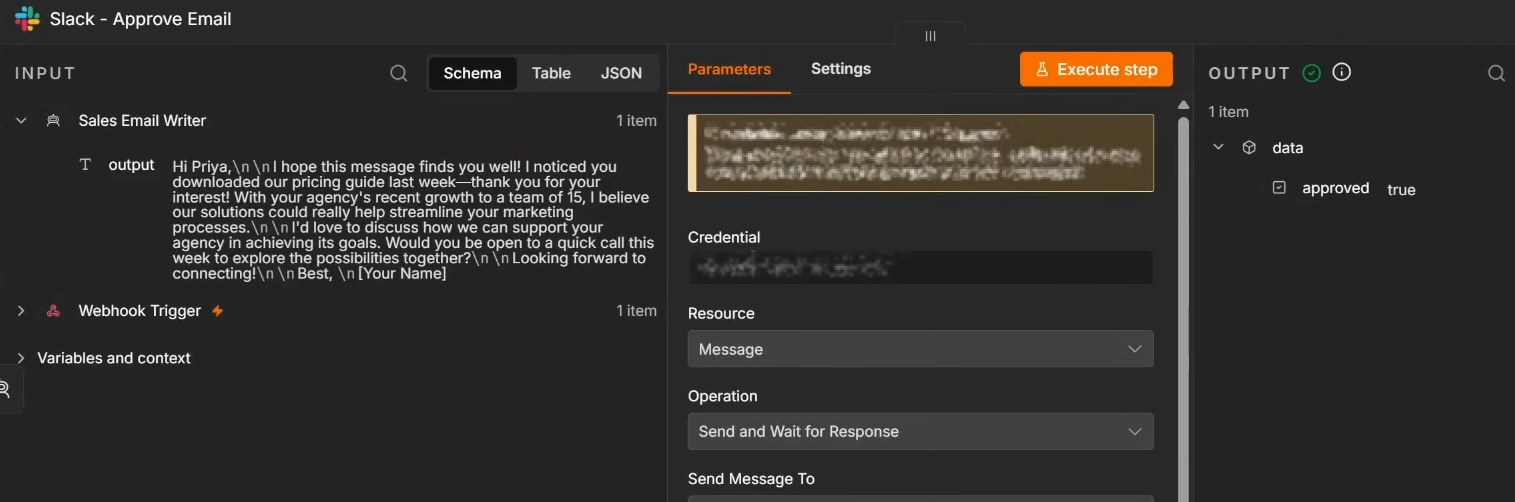
Не всё стоит пускать на автопилот. Агент пишет письмо новому лиду, но блок Slack в режиме «Send and Wait for Response» сначала публикует черновик в канал с кнопками одобрить и отклонить. Поток встаёт на паузу. Если одобрено, Gmail отправляет письмо. Если отклонено, пустой блок завершает поток, ничего не уходит. Такой приём нужен везде, где ошибка стоит дорого.
Шаг 11. Ошибки и мониторинг
Поток с долгой памятью зависит от трёх внешних вызовов: чтение истории, агент и запись реплики. Любой может упасть, и пользователь останется без ответа. Что добавляют:
- Повторы. Сначала поток пробует ещё раз.
- Запасной ответ. Пути ошибок трёх блоков ведут в блок «Уведомить об ошибке», пользователь получает короткое сообщение в Telegram.
- Оповещение владельцу. Если ломается сам поток, владелец получает сообщение с текстом ошибки.
Следить стоит за тремя показателями: время запуска, доля сбоев и расход токенов. Собрать это можно из Google Sheets и Telegram. Расписание раз в час забирает последние запуски через API самого n8n, блок Code считает число запусков, сбоев, долю сбоев и среднее время, строка пишется в таблицу. Если доля сбоев 10% или выше, в Telegram приходит сообщение, иначе тишина.
Токены считает отдельный блок: ответ блока с ИИ содержит токены запроса, ответа и общее число. Их достают и пишут в свою вкладку таблицы. Фрагмент копируется к любому блоку с ИИ.
Что дальше
Начните с одного потока на скучной задаче, например разбора входящих заявок. Добавьте согласование и оповещения об ошибках, и только потом агентов и память. Хорошая автоматизация это не самый умный агент, а понятная цепочка: кто что делает, где остановка на проверку и кто узнает о сбое.
Мы в Агентехе учим сотрудников собирать ИИ-агентов и автоматизации под задачи своего отдела: от первого потока до согласования, памяти и контроля ошибок. Как устроено обучение.