Ollama на бесплатном GPU Kaggle: сервер для кодинг-агента, что получится и что нет. Пошагово
Содержание
- Что даёт Kaggle бесплатно
- Шаг 1. Выбираем модель
- Шаг 2. Собираем цепочку
- Шаг 3. Что происходит с двумя картами
- Шаг 4. Понимаем, почему агент молчит
- Шаг 5. Помним, что это квота, а не видеокарта
- Шаг 6. Считаем, сколько стоит бесплатная неделя
- Шаг 7. Пробуем бесплатный TPU
- Что важно знать до старта
- Если вы работаете из России
- Кому это подходит
Кодинг-агенту нужна модель, а хорошая модель на своём компьютере почти всегда упирается в видеокарту. Карта для комфортной работы стоит тысячи долларов, и поэтому все ищут бесплатный обходной путь. Самый популярный сейчас: платформа Kaggle, которая бесплатно даёт GPU, плюс Ollama, плюс туннель наружу, и готовый «свой сервер» подключается к кодинг-агенту.
О способе много говорят, потому что на бумаге всё сходится: 32 ГБ видеопамяти, сильная открытая модель, ноль долларов. На практике у схемы есть три подводных камня, о которых в коротких инструкциях молчат. Разберём, как сервер собирается, где он ломается и для чего его стоит использовать.
Что даёт Kaggle бесплатно
Kaggle это площадка для задач по данным и машинному обучению, она принадлежит Google. Бесплатный тариф доступен после подтверждения номера телефона. Банковская карта не нужна, пробного срока нет.
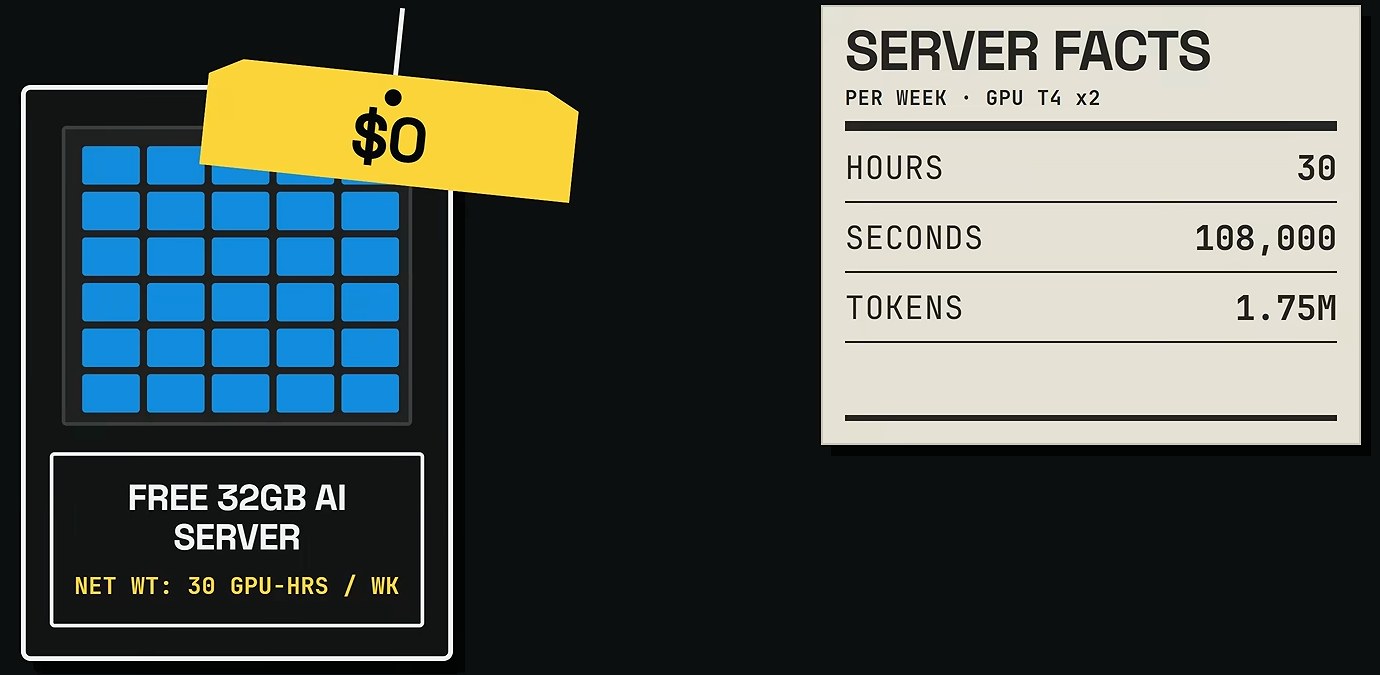
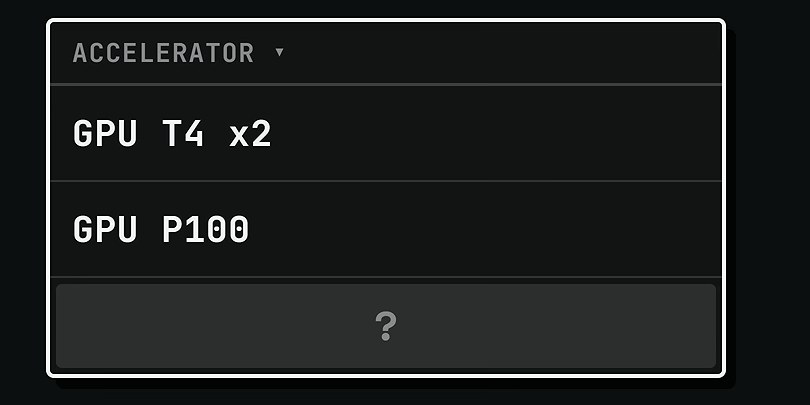
В квоту входит около 30 GPU-часов в неделю. В меню ускорителей есть вариант GPU T4 x2: две карты Nvidia Tesla T4 по 16 ГБ, всего 32 ГБ видеопамяти. Карта T4 вышла в 2018 году, так что железо не новое.
Шаг 1. Выбираем модель
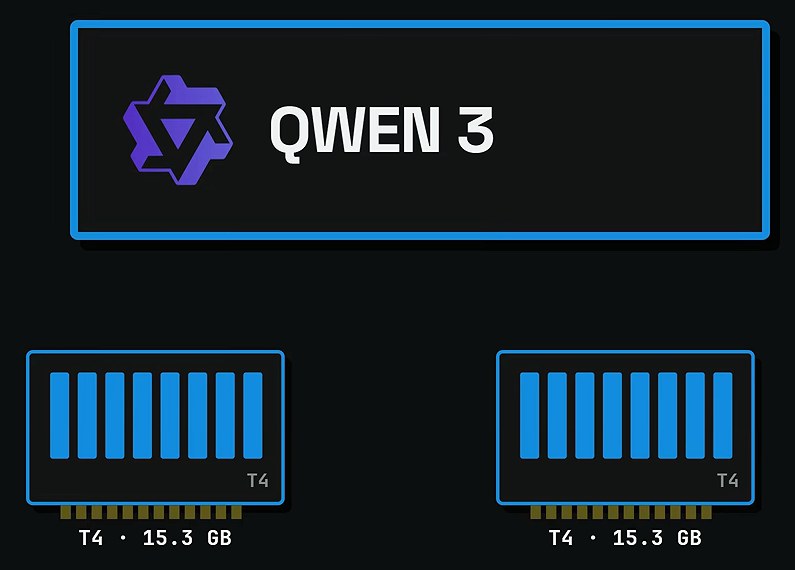
В таких сборках берут Qwen 27B: открытая модель с лицензией Apache, умеет писать код и рассуждать. Её скачали около 6,8 млн раз за месяц на Hugging Face.
Версия в 4-битном сжатии весит около 17 ГБ. А на каждой карте T4 в Kaggle доступно 15,3 ГБ. В одну карту файл не помещается, и это определяет всё остальное.
Шаг 2. Собираем цепочку
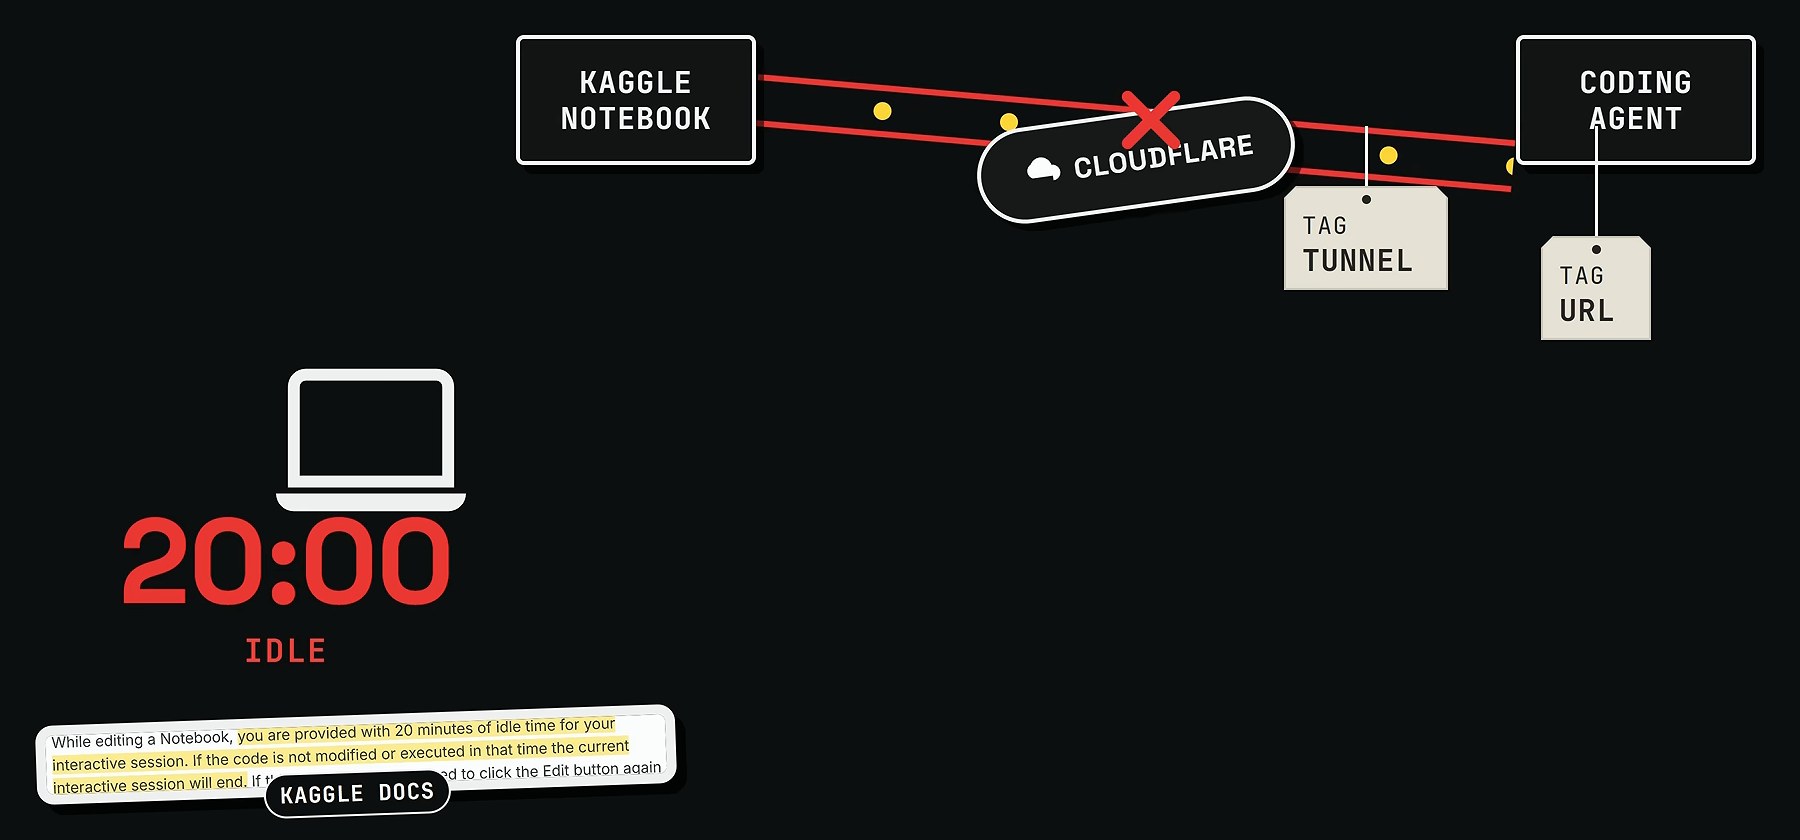
Схема из четырёх звеньев:
- Ноутбук Kaggle. Там выбирается ускоритель GPU T4 x2.
- Ollama. Через неё в ноутбук скачивается модель, она же запускает сервер.
- Туннель Cloudflare. Он открывает ноутбук наружу и выдаёт публичный адрес.
- Кодинг-агент. В него вставляют этот адрес. В примере это Claude Code или Hermes.
Точные команды зависят от версий, поэтому берите их из документации Ollama и Cloudflare. Результат: «свой» сервер на 32 ГБ, к которому подключён агент.
Шаг 3. Что происходит с двумя картами
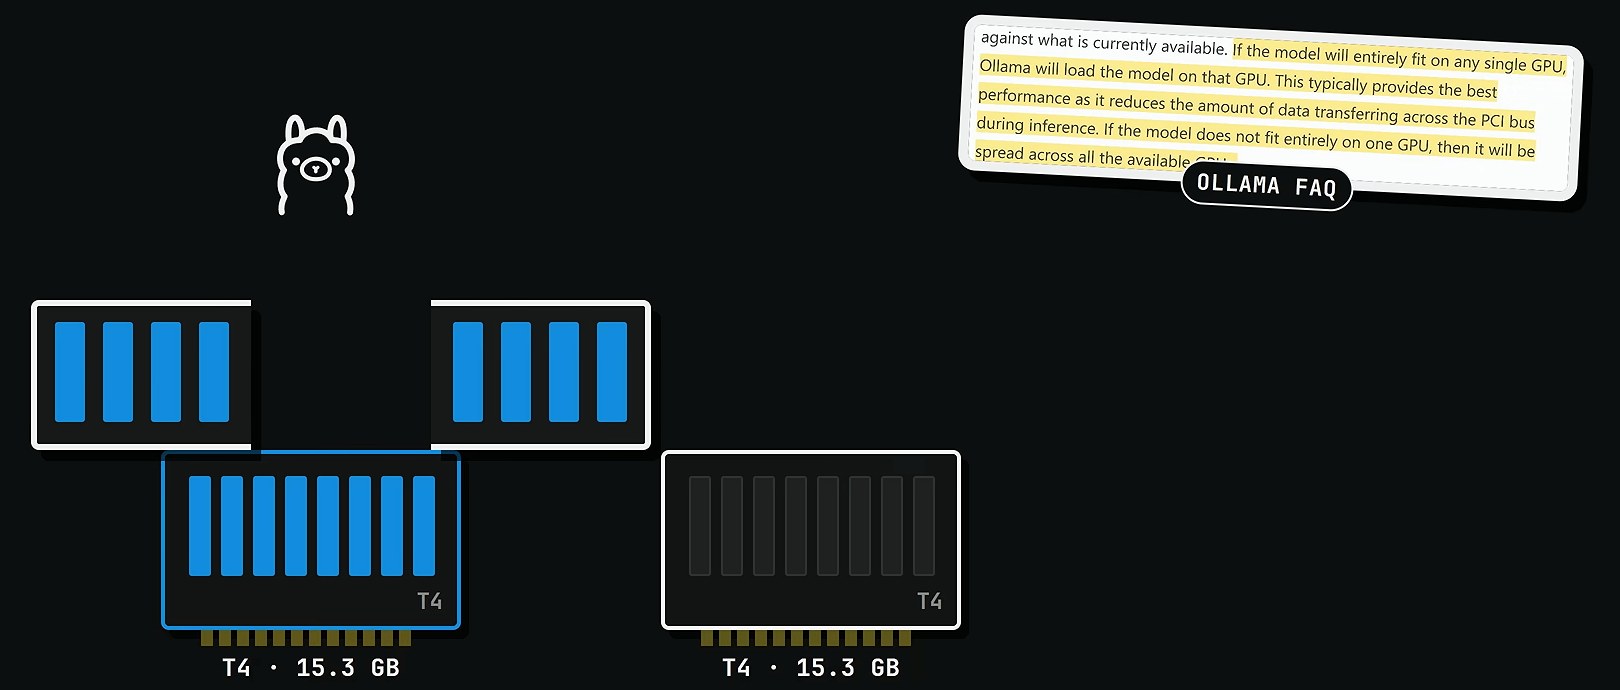
Две карты звучат как двойная мощность. На деле нет. Раз модель не помещается в одну карту, Ollama делит её по слоям: половина лежит на первой карте, половина на второй. Чтобы выдать один токен, сначала читает свою половину первая карта, пока вторая простаивает. Потом наоборот. Это эстафета, а не командный подъём.
По документации Ollama, если модель целиком влезает в одну карту, она грузится в неё, а если нет, распределяется по всем доступным. Итог: объём памяти как у двух карт, скорость как у одной.
В замерах это 16,23 токена в секунду, а один из пользователей писал, что выше 18 у него не получилось. Это не совпадение, а предел памяти карты. Для написания кода это терпимо.
Шаг 4. Понимаем, почему агент молчит
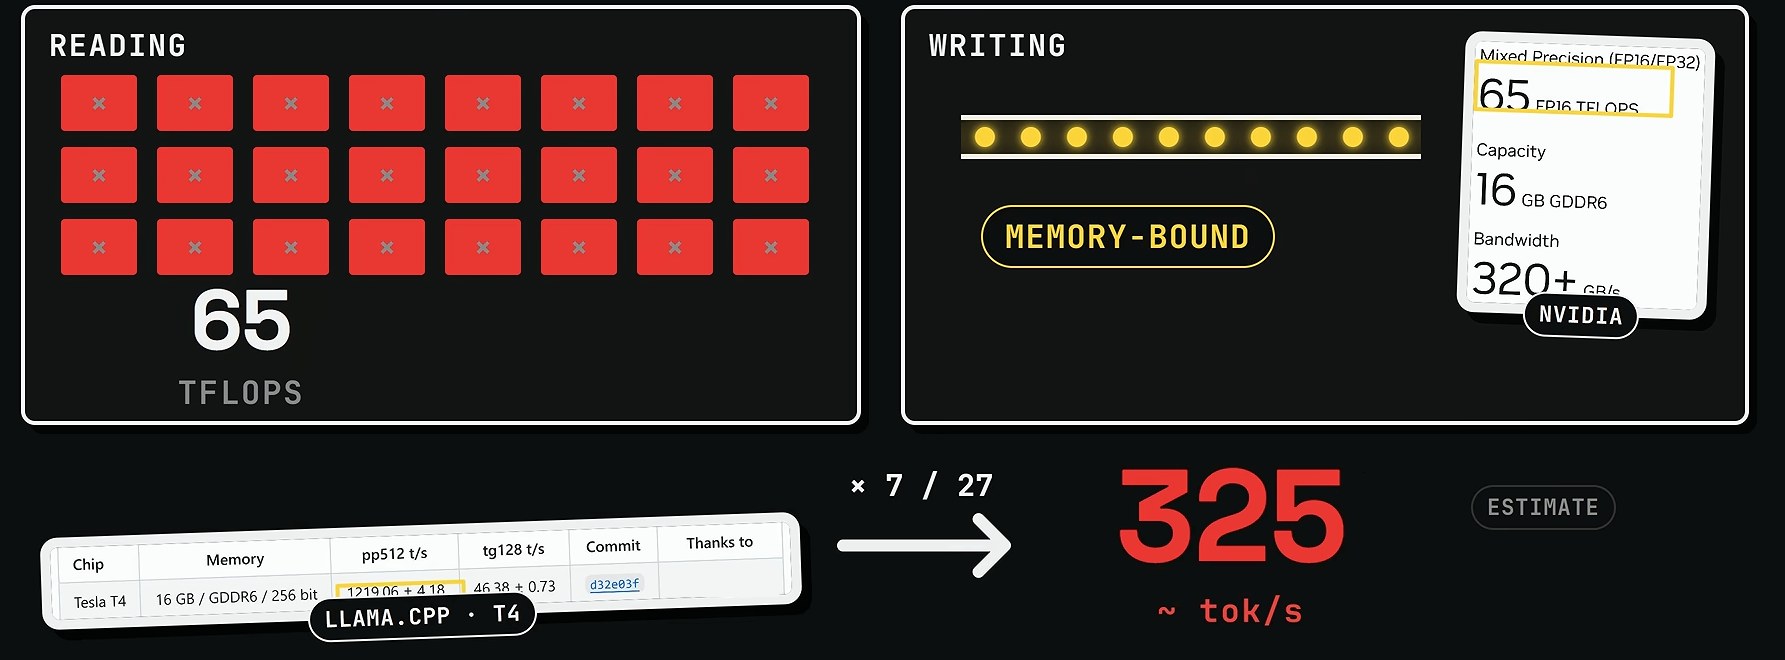
Каждый раз перед ответом возникает пауза. Это предзаполнение: прежде чем написать первое слово, модель читает всё, что ей отправили. Сообщение, файлы, историю диалога и системный промт агента. В Claude Code системный промт, по сообщениям пользователей, занимает около 30 000 токенов ещё до первого слова человека.
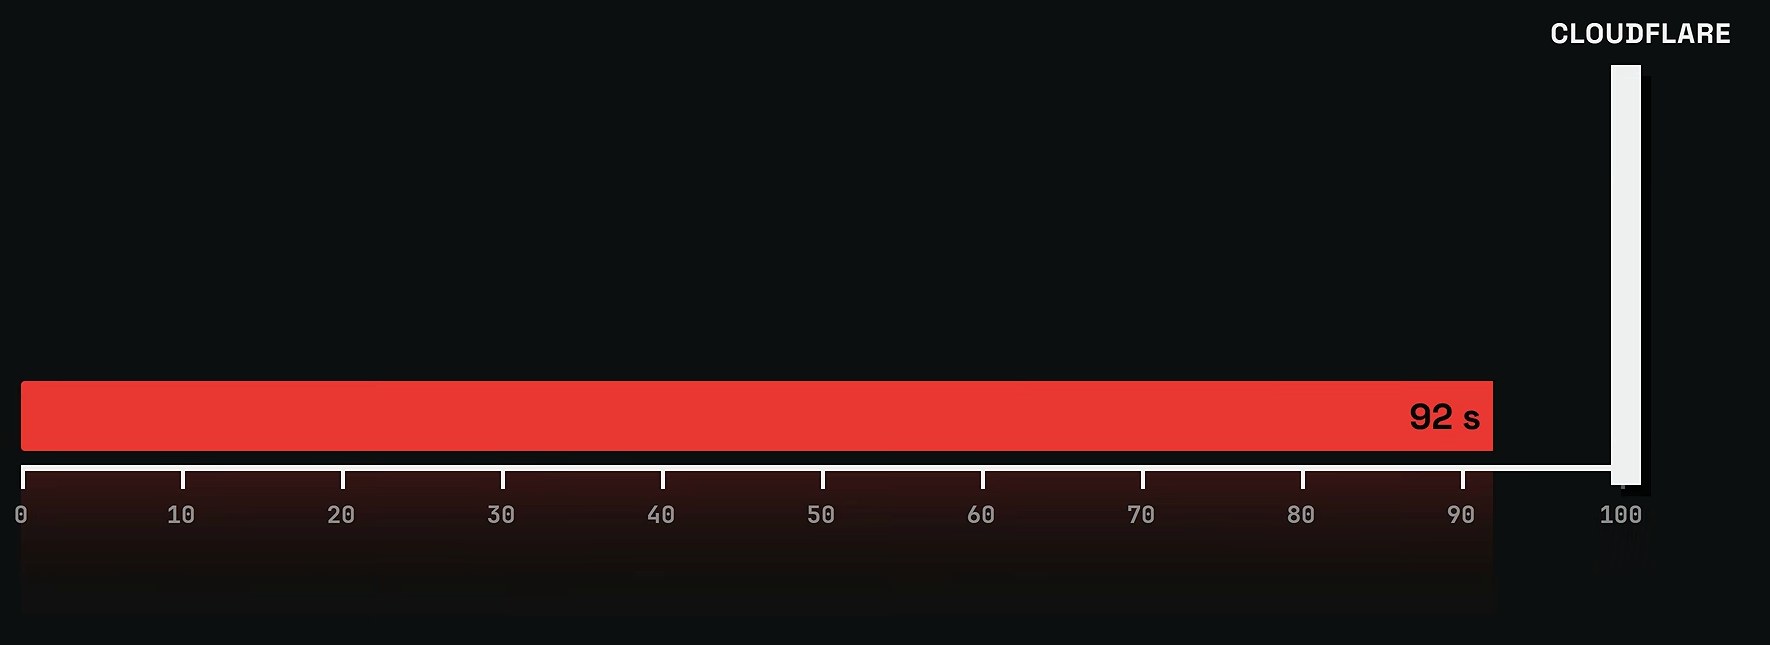
Чтение нагружает вычисления, а не память. У T4 это 65 терафлопс. Оценка для модели на 27 млрд параметров: около 325 токенов в секунду на чтении. Выходит, что 30 000 токенов агентского промта читаются около 92 секунд, и всё это время ответа нет.
Теперь про туннель. Быстрый туннель Cloudflare, который использует каждая такая инструкция, обрывает запрос, если ответа нет 100 секунд. Лимит нельзя поменять на бесплатном тарифе, это возможно только на корпоративном. Запас получается 8 секунд, а при их превышении приходит ошибка 524. Поэтому в отзывах к таким сборкам полно ошибок 502, 504 и «провайдер недоступен». Один из авторов сборок сам советует: если первое сообщение не прошло, отправьте его снова.
Шаг 5. Помним, что это квота, а не видеокарта
Сессия на Kaggle живёт не дольше 12 часов. Если ноутбук простаивает, а это может случиться уже через 20 минут, сессия заканчивается. Вместе с ней исчезают скачанная модель, Ollama, туннель и адрес, который вы вставили в агента. После нового запуска адрес другой, и конфиг агента придётся обновить.
Холодный старт, по отзывам, занимает от 15 до 30 минут, и они тоже списываются из недельной квоты.
Шаг 6. Считаем, сколько стоит бесплатная неделя
30 часов это 108 000 секунд. При 16,23 токена в секунду и условии, что сервер выдаёт токены каждую секунду без настройки, простоев и чтения, получается около 1,75 млн токенов в неделю.
Та же модель продаётся через OpenRouter у примерно 20 компаний, и средняя цена за миллион выходных токенов составляет 2,46 доллара. Умножаем: 4,31 доллара. Это потолок бесплатной недели. Облачная версия не обрывается по таймауту, не просит телефон и не умирает при закрытой вкладке. Цены на облачные модели меняются каждый день, расчёт сделан на середину октября 2026 года.
Шаг 7. Пробуем бесплатный TPU
В том же меню Kaggle ниже T4 есть ещё один бесплатный вариант, который почти никто не выбирает: TPU VM. Это восемь чипов Google по 16 ГБ быстрой памяти, всего 128 ГБ. Память одного чипа примерно в 2,5 раза быстрее, чем у T4.
Раньше у него была причина оставаться без внимания: Qwen использует тип внимания, который программы для TPU не поддерживали. В августе поддержку добавили в vLLM версии 0.28.0, а следом появился проект kaggle-tpu-lab с лицензией MIT, около 579 звёзд на GitHub.
Проект запускает Qwen 27B в полной 16-битной точности: это 55,6 ГБ и контекст 262 000 токенов. По его собственным замерам:
- Запись. Около 130 токенов в секунду против 16 на двух T4, то есть в 8 раз быстрее.
- Чтение. Около 10 300 токенов в секунду против примерно 325, быстрее в 30 раз. Агентский промт на 30 000 токенов читается около 3 секунд, а не 92.
- Защита. Проект выдаёт ключ API, так что адрес не работает как пароль.
- Время запуска. Около 22 минут после нажатия на запуск.
Квота и проверка телефона те же, просто другой пункт в списке. Бесплатной работы на TPU около 20 часов в неделю.
Что важно знать до старта
- Правила Kaggle. С июня 2025 года в допустимом использовании прямо названы «фермы серверов» и активность, не связанная с машинным обучением. Туннель к ноутбуку и скрипт, который обманывает таймер простоя, один из авторов таких сборок назвал серой зоной. Запрета в документах не нашли, но аккаунт ваш, а правила чужие.
- Это не локальный запуск. Как только код идёт через туннель на серверы Google, он перестаёт быть локальным. Cloudflare сами пишут, что быстрые туннели нужны для тестов и без гарантий работы. Единственная причина запускать ИИ у себя, приватность кода, здесь теряется.
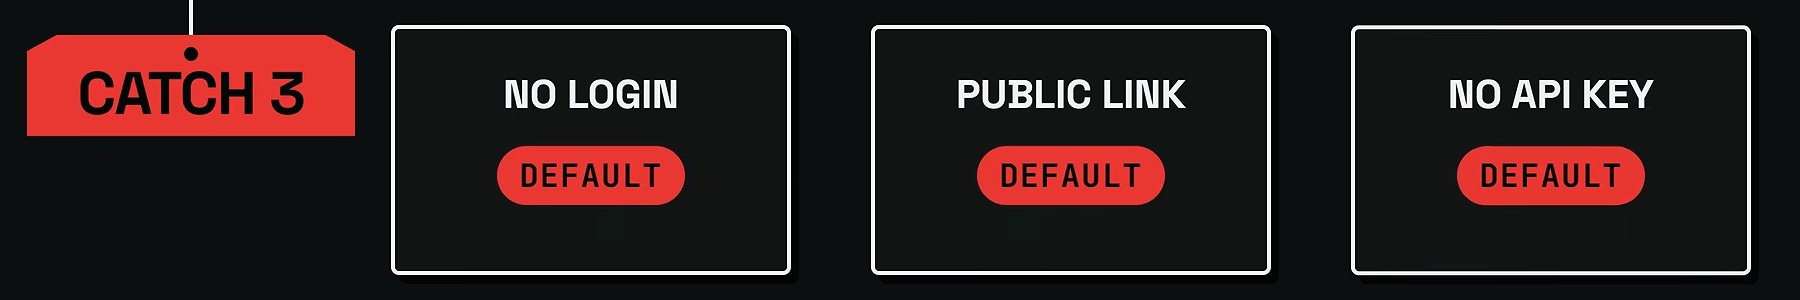
- Небезопасные настройки по умолчанию. У Ollama из коробки нет входа, и большинство инструкций выставляют её по публичной ссылке без ключа. Ссылка фактически становится паролем.
- Чужие копии моделей. Многие берут «нецензурированную» перезаливку от одного аккаунта на Hugging Face, а не официальный файл Qwen.
- Токен Kaggle для TPU. Проекту нужен API-токен для запуска из терминала. Код открытый, прочитайте его перед тем, как отдать токен.
- Сессия живёт недолго. Адрес меняется после каждого запуска, а простой сбрасывает всё.
Если вы работаете из России
Неизвестно, откроется ли Kaggle из России и пройдёт ли проверка телефона, поэтому проверьте это заранее. Если Kaggle недоступен, схема не работает целиком, ведь и ноутбук, и туннель Cloudflare зарубежные сервисы.
Что можно повторить без них. Ollama и Qwen с лицензией Apache открытые: их можно запустить на собственном сервере или компьютере с видеокартой. Так модель остаётся у вас и код никуда не уходит. Это тот самый случай, ради которого и стоит покупать железо. Если своей карты нет, подойдут российские облачные модели, если они справляются с вашей задачей: оценивайте их по тому же критерию, что и здесь, то есть по скорости чтения длинного промта и цене за миллион токенов.
Кому это подходит
Бесплатный Kaggle хорош для учёбы. Если нужно понять, как устроен сервер модели, как делить модель между картами, как настроить Ollama и туннель, лучшей песочницы не найти. Установили, сломали, починили, и ничего своего не пострадало. Пакетные задачи для Kaggle родные: дообучение, прогон 500 промтов через модель для оценки с сохранением результата. Студенту без бюджета TPU даёт сильную модель на 130 токенов в секунду с ключом API бесплатно.
Для ежедневной работы, где ноутбук открыт в 9 утра и агент отвечает сразу, неделя такого сервера стоит меньше обеда. Для сравнения: модель на Cerebras выдаёт 618 токенов в секунду по цене 1,49 доллара за миллион. Недельная квота Kaggle в токенах обойдётся меньше пяти долларов. Проще докупить кредитов.
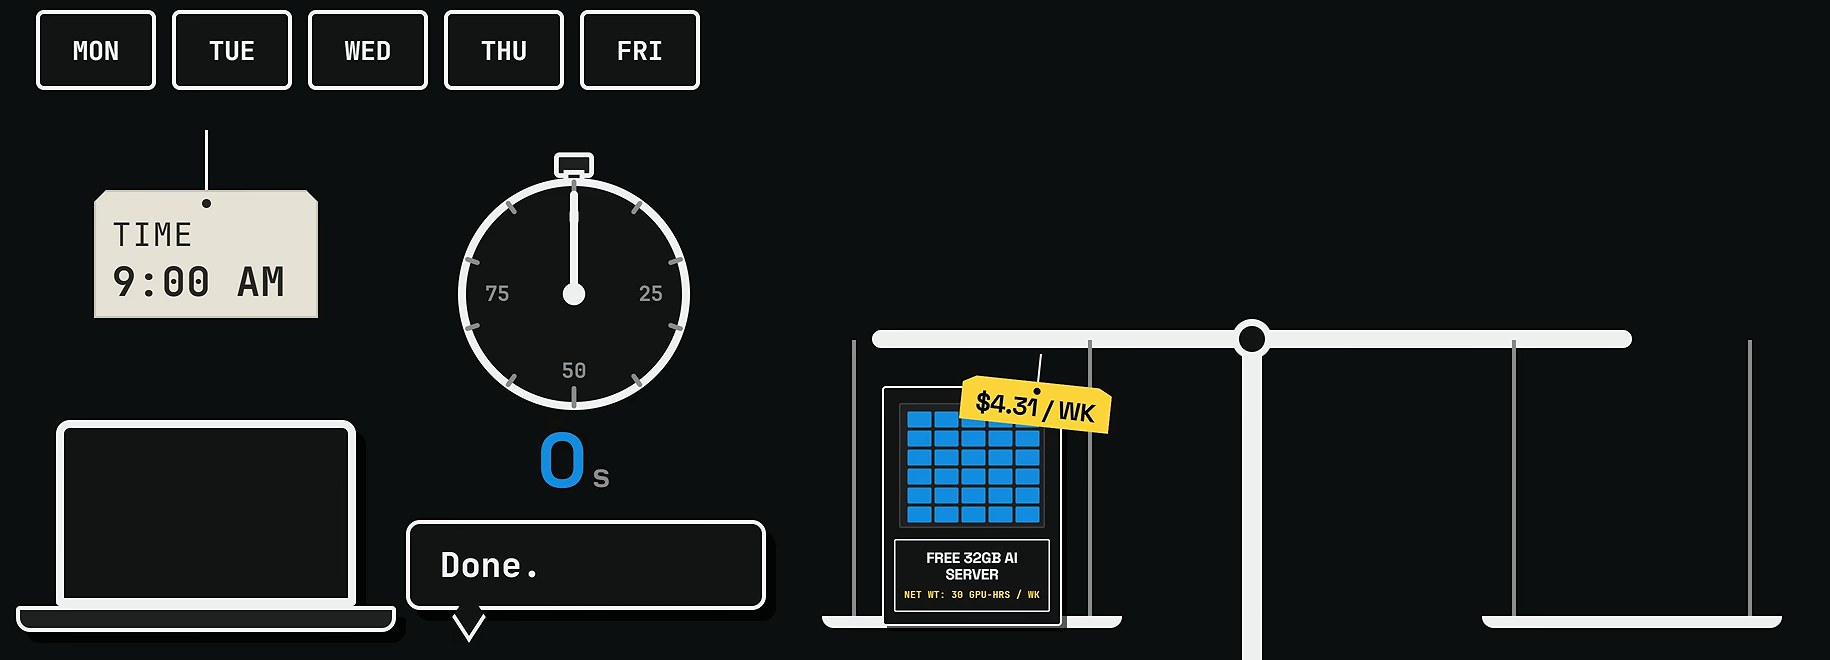
Итог такой. Хотите бесплатно: берите вариант с TPU и относитесь к нему как к лаборатории на один вечер, а не как к серверу, который работает всегда. Кодите каждый день: направьте агента на облачную модель. Покупайте видеокарту в тот день, когда код нельзя выпускать с вашего стола.
Мы в Агентехе учим сотрудников выбирать модель и среду для агентов под задачу и считать, во что обходится каждая схема: от бесплатных песочниц до собственного сервера. Как устроено обучение.